push 한 번으로 변경 서비스만 테스트 · 빌드 · 검사해 dev/prod에 배포하고 결과를 Slack으로 공유했습니다.
KT CLOUD TECH UP · 기본 + 심화 프로젝트
Medical MSA · CI/CD & Service Mesh
의료 MSA의 CI/CD · GitOps 배포를 자동화하고, 심화 단계에서 Istio를 올려 트래픽 전환 · 장애 복구 · 내부 접근 차단을 직접 실험했습니다.
01
프로젝트 개요
수동 배포에서 생기는 휴먼 에러와 서비스 중단을 줄이기 위해 배포를 자동화하고, 이어서 배포된 새 버전이 실제 트래픽과 장애 상황에서도 정상인지까지 확인하는 흐름을 만들었습니다.
환자 · 예약 · 처방 · 알림 서비스와 API Gateway로 구성된 의료 MSA를 대상으로 두 단계에 걸쳐 진행했습니다. 기본 단계(5주)에서는 GitHub Actions 기반 CI, 멀티스테이지 이미지 빌드, Trivy 보안 검사, 레지스트리와 Helm values 갱신부터 ArgoCD GitOps 배포, HPA · Probe · Rolling Update 같은 Kubernetes 운영 설정까지 배포 경로 전체를 맡았습니다. 심화 단계에서는 Observability 담당으로 AWS EKS 위에 Istio를 적용해 Canary · Blue/Green · Retry · Zero-Trust를 실험하고, Prometheus · Grafana · Kiali 관찰 환경과 장애 추적 순서를 정리했습니다.
Deploy → Traffic Shift → Observe → Recover를 하나의 운영 절차로 연결했습니다.
L7 가중치 제어, mTLS · AuthorizationPolicy, Kiali · Prometheus 연동을 근거로 Istio를 선택했습니다.
심화 단계는 노드 1~4대 범위로 운영하고, Pod마다 붙는 Envoy(100m / 128Mi) 비용을 함께 산정했습니다.
02
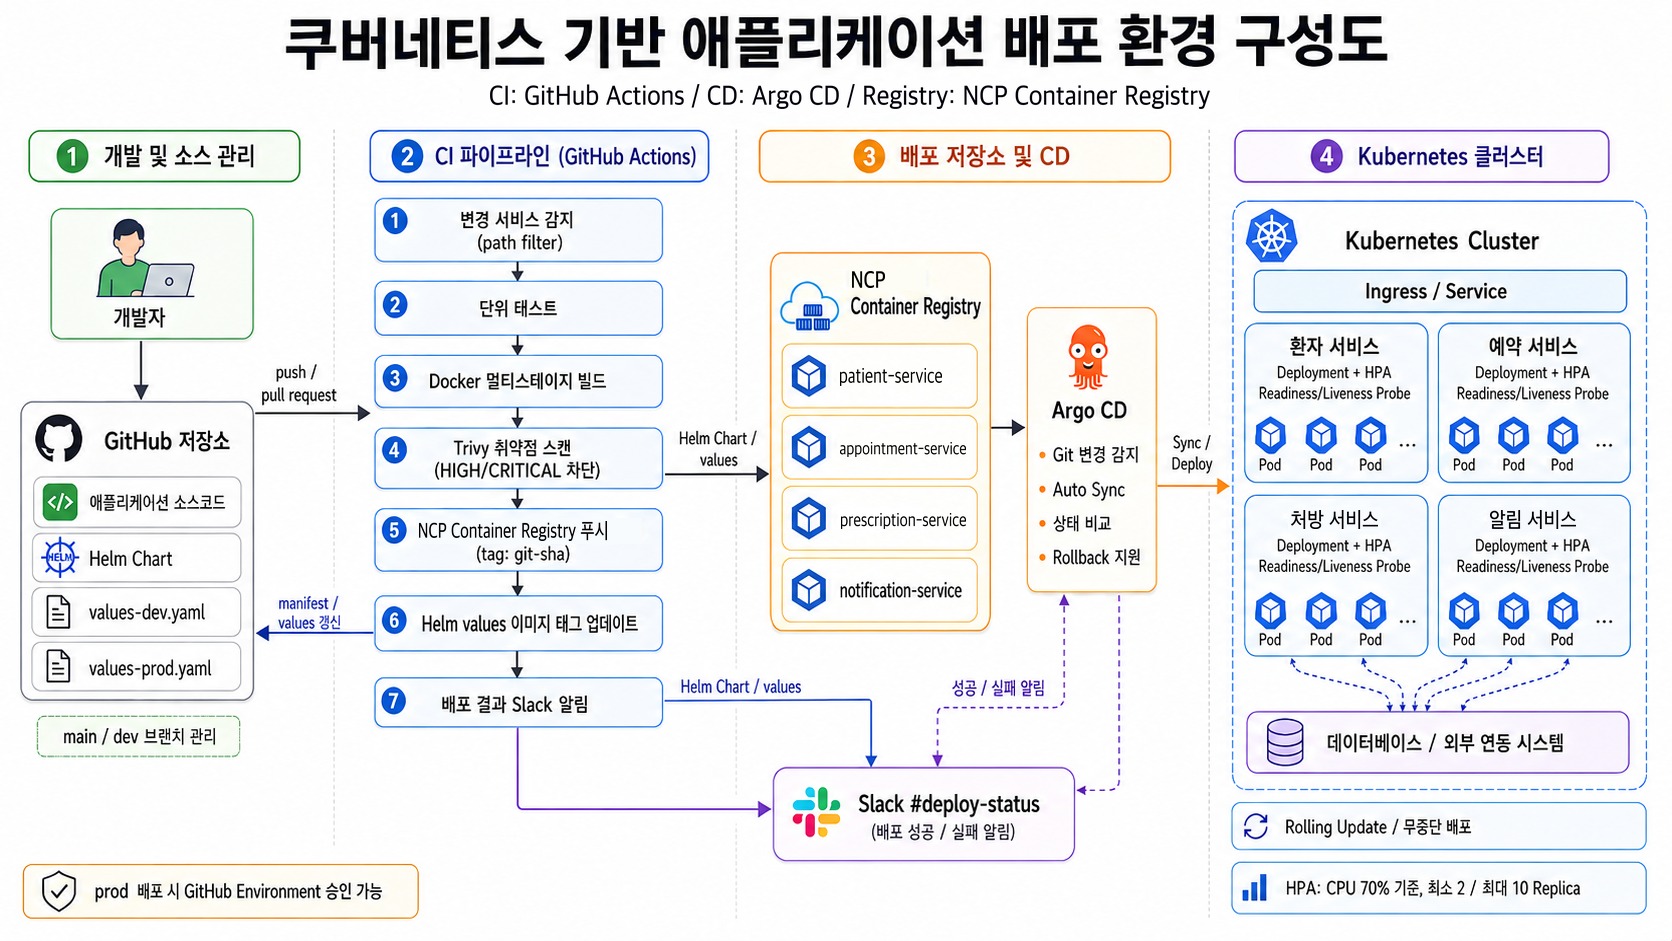
배포 흐름
GitHub ActionsPath Filter · Gradle Test
→
Image BuildMulti-stage · Buildx
→
TrivyHIGH · CRITICAL 차단
→
Registrygit-sha Tag Push
→
Helm valuesTag 갱신 · Commit
→
ArgoCDdev / prod Sync · Slack
03
담당 파트
기본 단계 · CI/CD · GitOps · Kubernetes 운영
서비스별 Path Filter로 수정된 서비스만 골라 Matrix로 빌드하고, Gradle 테스트가 실패하면 그 자리에서 파이프라인을 멈췄습니다.
빌드는 eclipse-temurin:17-jdk, 실행은 17-jre로 나눠 실행 이미지를 줄이고, 컨테이너를 비루트 사용자로 실행했습니다.
HIGH · CRITICAL 취약점이 있으면 exit-code 1로 실패시켜, 검사를 통과한 이미지만 레지스트리에 올라가도록 했습니다.
이미지를 git-sha로 태깅해 레지스트리에 Push하고, Helm values의 이미지 태그를 갱신 · 커밋해 ArgoCD 배포로 이어지게 했습니다.
변경 서비스 목록, 빌드 결과, Helm 갱신 결과, 커밋 · 배포자 · workflow 정보를 #deploy-status로 보내 GitHub에 들어가지 않고도 배포 상태를 확인하게 했습니다.
QEMU · Docker Buildx로 멀티 플랫폼 빌드를 구성하고, 비용 지원 제한에 맞춰 레지스트리를 KT Cloud에서 NCP로 옮겼습니다.
심화 단계 · Observability
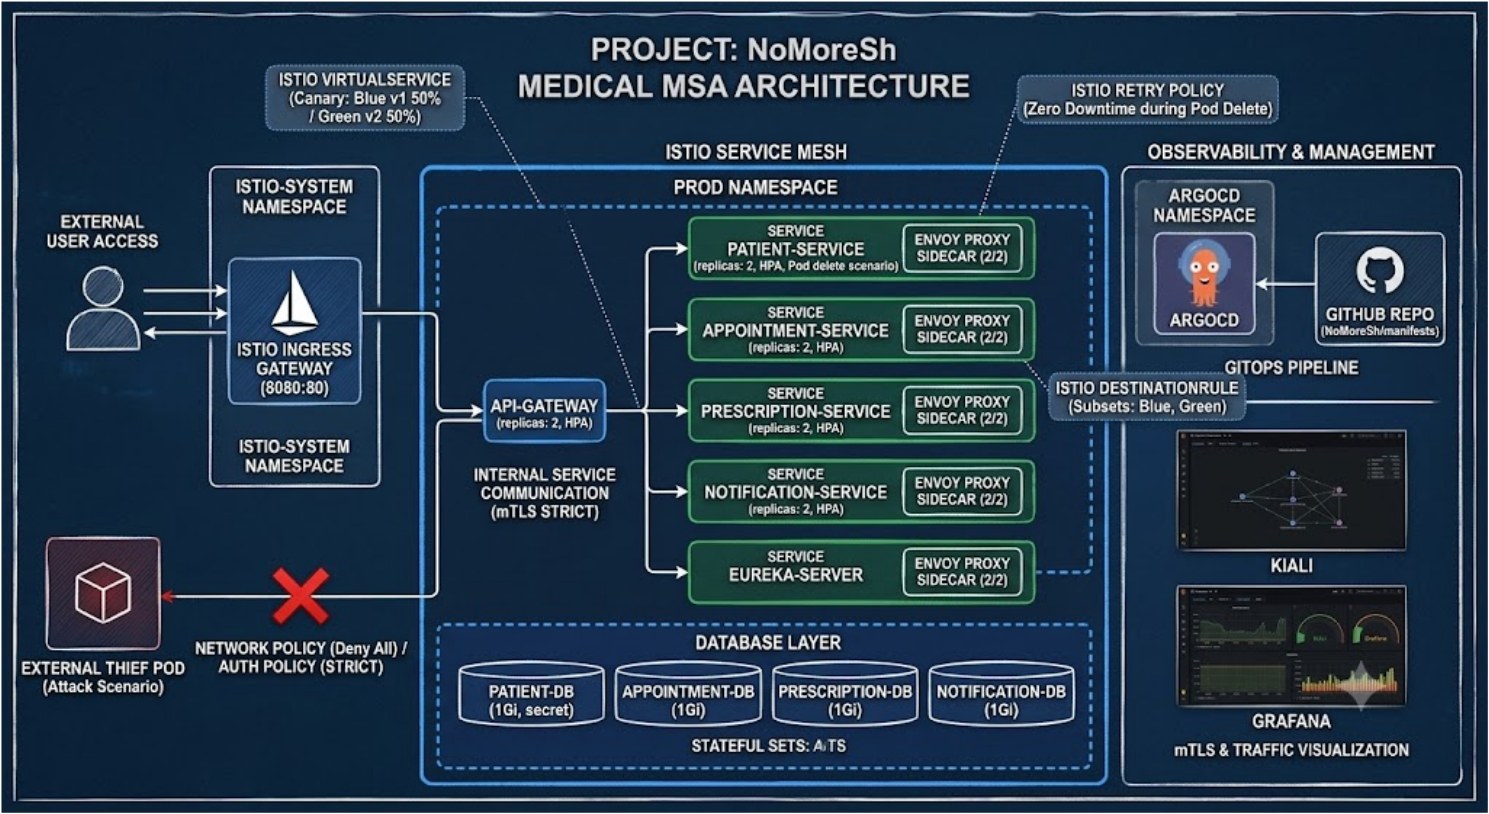
Kubernetes 컴포넌트와 Istio · Envoy 메트릭을 수집 대상으로 연결하고, Grafana에서 서비스별 요청량과 사이드카 리소스 점유율을 보도록 구성했습니다.
Ingress Gateway부터 각 서비스까지 호출 관계를 Mesh 관점으로 그려, 실패 지점과 버전별 트래픽 흐름을 확인했습니다.
Grafana로 요청량 · 5xx · 리소스 수치 확인 → Kiali로 호출 단절 구간 확인 → ArgoCD로 배포 상태와 Git 이력을 대조해 복구하는 순서를 정했습니다.
04
GitOps · K8s 운영
이미지가 올라간 뒤 클러스터에 배포되고, 배포 중과 장애 상황에서도 서비스가 유지되도록 설정하고 직접 검증했습니다.
| GitOps | 하나의 Chart, 두 개의 환경charts/medical 하나에 values-dev · values-prod를 두고 ArgoCD Application(medical-dev / medical-prod)을 나눠, dev에서 먼저 배포를 검증하고 환경별 Sync · Health를 따로 확인했습니다. |
|---|---|
| HPA | CPU 70% 기준 2 ~ 10 Replica 최소 2개 Pod를 유지하고, 부하가 늘면 자동으로 늘렸다가 줄어들면 다시 축소합니다. |
| Probe | Readiness /health/ready · Liveness /health준비된 Pod만 트래픽을 받고, 비정상 Pod는 자동으로 재시작됩니다. DB 장애와 Memory Leak을 일부러 일으켜 Probe 실패(HTTP 500)를 유도하고, 실패 이벤트를 cron 스크립트로 수집해 Pod별 로그로 남겼습니다. |
| Rolling Update | maxSurge: 1 · maxUnavailable: 0새 Pod가 준비된 뒤에 기존 Pod를 내려 배포 중 트래픽이 끊기지 않게 했습니다. |
05
Service Mesh 검증
| Canary | 20% → 50% → 70% → 100% VirtualService 가중치만 바꿔 새 버전 트래픽을 단계적으로 늘렸습니다. curl을 반복 호출해 지정한 비율대로 요청이 나뉘는 것을 로그로 확인했습니다. |
|---|---|
| Blue / Green | 50:50 → 0:100 즉시 전환 두 버전을 띄워 둔 상태에서 라우팅 대상을 한 번에 바꿨습니다. 클라이언트 쪽 단절 없이 응답이 Blue에서 Green으로 바뀌는 것을 확인했습니다. |
| Retry | Pod 강제 종료 중 클라이언트 성공 유지 VirtualService에 retries.attempts: 3을 넣고, 요청을 보내는 도중 kubectl delete pod로 Pod를 종료했습니다. Envoy가 503을 받고 살아 있는 Pod로 재시도해 클라이언트 요청은 모두 성공했습니다. |
| Zero-Trust | 비인가 Pod의 내부 접근 차단 mTLS STRICT와 AuthorizationPolicy를 적용한 상태에서 Mesh 밖의 Pod를 띄워 백엔드 주소로 직접 요청했습니다. RBAC: access denied로 차단되는 것을 확인했고, Canary 경로로 다시 시도해도 같은 결과였습니다. |
06
트러블슈팅
빌드 아키텍처 차이로 배포 실패
| 증상 | CI에서 만든 이미지가 배포 환경에서 실행되지 않아 배포가 실패했습니다. |
|---|---|
| 원인 | 이미지를 빌드한 환경과 실행 환경의 CPU 아키텍처가 달랐습니다. |
| 해결 | QEMU와 Docker Buildx로 멀티 플랫폼 빌드 파이프라인을 구성해, 실행 환경에 맞는 이미지를 CI에서 바로 만들도록 변경했습니다. |
openjdk 베이스 이미지 지원 종료
| 증상 | Dockerfile이 쓰던 openjdk 공식 이미지가 Docker Hub에서 지원 종료돼, 보안 업데이트를 더 받을 수 없게 됐습니다. |
|---|---|
| 해결 | 베이스 이미지를 eclipse-temurin으로 교체하고, 이 기회에 jdk(빌드) / jre(실행) 멀티스테이지 구조와 비루트 실행을 함께 적용했습니다. |
비용 제한으로 레지스트리 이전
| 증상 | 서버 비용 지원이 제한되면서 KT Cloud Container Registry를 계속 쓸 수 없게 됐습니다. |
|---|---|
| 해결 | 레지스트리를 Naver Cloud Platform으로 옮기고, CI의 Push 단계를 NCP Registry 기준으로 바꿔 배포 흐름을 그대로 유지했습니다. |
메트릭 수집 중 DNS · 네트워크 timeout (심화)
| 증상 | Kubernetes와 Istio · Envoy 메트릭을 Prometheus 수집 대상으로 연결하는 과정에서 DNS · 네트워크 timeout이 발생했습니다. |
|---|---|
| 추적 | Prometheus 수집 상태와 Kiali의 서비스 간 호출 관계 · 에러 지점을 함께 보며 문제 구간을 좁혔습니다. |
| 결과 | 수집 대상 연동을 정상화하고, Grafana에서 서비스 · 사이드카 지표를 확인할 수 있게 됨 |
운영 중 클러스터 리소스 고갈 (심화)
| 증상 | 실험을 진행하는 중 클러스터의 컴퓨팅 자원이 고갈됐습니다. |
|---|---|
| 원인 | 프로젝트에 필요한 컴퓨팅 리소스 총량을 사전에 정확히 예측하지 못했습니다. |
| 해결 | 노드 그룹 범위(1~4대) 안에서 운영 중 노드를 Scale-out해 자원을 재분배했습니다. |
| 결과 | 운영 중 노드를 늘려 자원을 다시 분배하는 동적 확장을 직접 검증하고 실험을 이어 감 |
07
검증 결과
배포 자동화부터 트래픽 전환 · 장애 복구 · 접근 차단까지 실제 시나리오로 재현하고 확인했습니다.
기본 단계에서는 직접 만든 파이프라인으로 4개 서비스가 push 한 번으로 테스트 · 검사를 거쳐 배포되고, ArgoCD에서 Synced · Healthy로 유지되는 것을 확인했습니다. 심화 단계에서는 "배포 완료"가 아니라 "새 버전이 트래픽을 정상 처리하는가", "장애가 나도 사용자는 실패를 보지 않는가"까지 확인해야 운영이 끝난다는 기준을 팀의 Runbook으로 정리했습니다.
CI/CD4개 서비스 자동 배포
Trivy 통과 이미지만 반영
RETRY성공률 100%
Pod 강제 종료 중
CANARY4단계 전환
20 → 50 → 70 → 100%
08
회고
심화 단계에서 배포 파이프라인과 트래픽 제어에 집중하느라, VPC와 EKS 클러스터 같은 클라우드 자원은 Terraform 같은 코드가 아닌 셸 스크립트로 만들었습니다.
다시 한다면Terraform으로 클러스터 바깥 인프라까지 선언형으로 관리하겠습니다. 다음 프로젝트(Hotel Booking)에서 EKS와 ArgoCD를 Terraform으로 구성하며 이 부분을 이어서 해결했습니다.
비용 제한으로 레지스트리를 옮기고, 심화 단계에서는 프리티어 자원 제약과 IAM 사용자 권한 매핑 문제로 클러스터 생성과 접근 권한 확보가 반복해서 지연됐습니다.
다시 한다면사이드카 비용을 포함한 리소스 총량과 비용을 먼저 산정하고, 팀원별 클러스터 접근 권한을 생성 시점에 코드로 함께 정의하겠습니다.
Tech Stack: GitHub Actions · Docker Buildx · QEMU · Trivy · NCP Container Registry · Helm · ArgoCD · Kubernetes HPA · AWS EKS · Istio · Envoy · Prometheus · Grafana · Kiali · Slack